Comunicando salió en octubre de 2004 y fue el primer podcast en español: así funcionaba aquello por dentro
- Publicado
- Sección
- General
- Firma
- sofia_salas
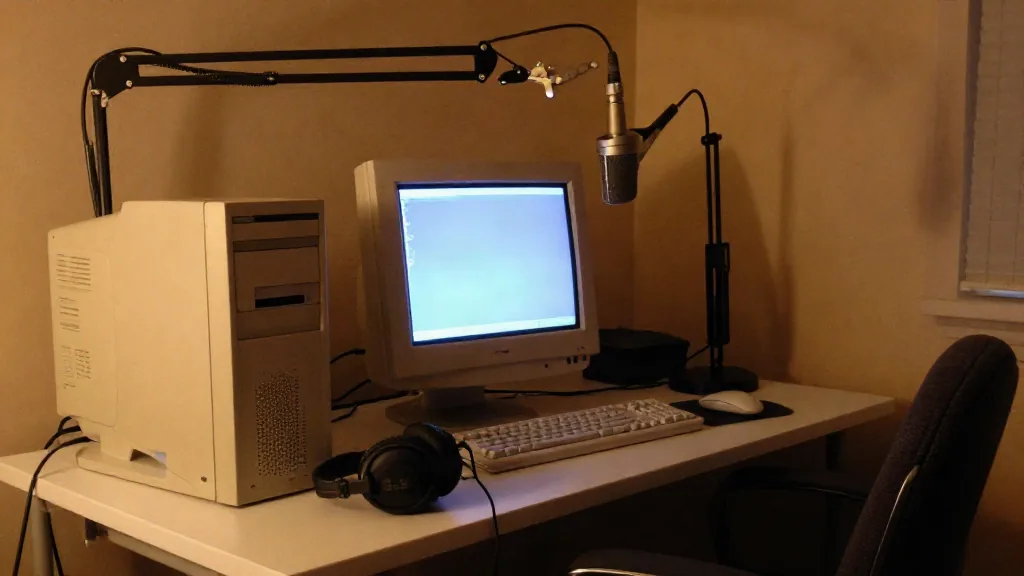
En octubre de 2004, un periodista tecnológico llamado José Antonio Gelado se sentó delante de un micrófono en su casa, grabó unos minutos hablando de tecnología, guardó el resultado en un MP3 y lo subió a su servidor. Hasta ahí, poca novedad: en internet había audio colgado desde mediados de los noventa. Lo que hizo después es lo que convierte aquello en el primer podcast en español del que hay constancia: añadió una línea a un fichero XML para que el programa se descargara solo en el ordenador de cualquiera que se hubiese suscrito. El programa se llamaba Comunicando.
Ocho meses antes, el 12 de febrero de 2004, el periodista Ben Hammersley había publicado en The Guardian un artículo sobre esa manía nueva de repartir audio por suscripción y, buscando cómo llamarla, soltó de pasada la palabra podcasting. Era un juego con iPod y broadcasting, escrito sin darle importancia. Se quedó.
Un fichero XML con una línea de más
La pieza técnica que hizo posible el invento no se diseñó para esto y llevaba casi cuatro años criando polvo. A finales de 2000, Dave Winer metió en la versión 0.92 de RSS una etiqueta llamada enclosure: un campo donde una entrada de un feed podía apuntar a un fichero adjunto, con su dirección, su tamaño en bytes y su tipo. En enero de 2001, Winer la estrenó él mismo adjuntando una canción de los Grateful Dead a una entrada de su blog. Y ahí se quedó, sin que casi nadie la usara, hasta que Adam Curry escribió un programita que hacía lo obvio: mirar cada cierto tiempo los feeds a los que uno estaba suscrito, ver si había un enclosure nuevo y bajárselo al disco duro mientras el usuario dormía.
Ese era todo el mecanismo, y merece la pena verlo despacio porque hoy está escondido debajo de un botón de play. El oyente instalaba un programa —un podcatcher— y le pegaba la dirección del feed. El programa preguntaba al servidor del autor, sin intermediarios, si había algo nuevo. Si lo había, descargaba el MP3, lo dejaba en la biblioteca de iTunes y, al enchufar el iPod por el cable, el episodio viajaba al reproductor. Nadie más participaba en la operación. No había cuenta, ni registro, ni recomendación, ni una empresa en medio decidiendo qué se veía. Dos ordenadores hablando por HTTP.
El problema, en español, era encontrar los feeds. Durante los primeros meses la única manera de saber qué podcasts existían fue una lista mantenida a mano. De eso se ocupó Podcastellano, que documentó el fenómeno, explicó cómo montarse uno, tradujo la jerga y llevó el censo de programas cuando el censo se podía llevar en una página. En 2005 aquello pasó de decenas de programas a varios cientos, y el directorio manual dejó de ser viable, que es la señal habitual de que algo ha empezado a funcionar.
Quién pagaba los megas
La economía de aquellos primeros programas era mala de una forma muy concreta: el éxito costaba dinero. Una hora de audio en MP3 a 64 kbps ocupa unos 28 megas. Mil descargas de un solo episodio son 28 gigas de transferencia. En 2005, un alojamiento normal en España venía con unos pocos gigas de tráfico al mes, y pasarse significaba una factura o la web cerrada hasta el mes siguiente. El podcaster que triunfaba se arruinaba antes de tener oyentes suficientes para vender nada.
Se apañó como se pudo. Unos subían los ficheros a Archive.org, que aceptaba material libre y no cobraba por el ancho de banda. Otros pagaron a Liberated Syndication, montada en 2004 como primer alojamiento pensado solo para esto, que cobraba por lo que subías y no por lo que se descargaba: tarifa plana con el riesgo del lado del proveedor. Publicidad no había prácticamente ninguna, entre otras cosas porque nadie sabía cuánta gente escuchaba. Un feed solo deja registros de descarga en el servidor, y una descarga no es una escucha. Esa ceguera de medición sigue existiendo veinte años después y es la razón de fondo de que el sector se haya ido metiendo en plataformas que sí saben contar.
El 28 de junio de 2005 Apple metió un directorio en iTunes
La versión 4.9 de iTunes incorporó un directorio de podcasts dentro del programa que ya estaba instalado en millones de ordenadores por el iPod. Apple lo abrió con más de 3.000 programas y anunció que en los dos primeros días se habían registrado más de un millón de suscripciones. En diciembre de ese año, el New Oxford American Dictionary eligió podcast palabra del año.
Lo decisivo de aquella jugada no fue el escaparate, sino lo que Apple decidió no hacer. El directorio no alojaba el audio: guardaba la dirección del feed del autor y punto. Suscribirse desde iTunes era exactamente lo mismo que suscribirse a mano, con la ficha bonita delante. Apple se quedó con el catálogo y dejó los ficheros donde estaban, en el servidor de cada uno. Por eso, cuando Apple perdió el interés y dejó aquello quieto durante más de una década, no se cayó nada.
Por qué el podcast aguantó y el blog no
La comparación con la blogosfera de aquellos mismos años es cruel. Los blogs vivían de un intermediario: Google, los agregadores, Menéame, después Facebook. El lector no venía a por ti, venía rebotado, y el día que el intermediario cambió el algoritmo o cerró la puerta, la audiencia desapareció sin que el autor tocara una sola línea de su web. Google Reader se apagó el 1 de julio de 2013 y se llevó por delante la costumbre de leer por suscripción.
El podcast se libró porque la suscripción vive en el aparato del oyente. Su programa pregunta directamente a tu servidor, todos los días, sin que nadie autorice la conversación. Solo se rompe si el oyente se da de baja o si el feed deja de responder. Y si un alojamiento sube el precio o cierra, el autor mueve los ficheros, cambia el enclosure y los suscriptores no se enteran. Esa portabilidad, que en 2004 era una consecuencia accidental de reutilizar RSS, es lo que ha sostenido el formato durante veinte años.
Lo que se está rompiendo ahora es justo eso. En España, iVoox lleva desde 2008 haciendo de plataforma con su propia audiencia; Spotify empezó en 2019 a comprar productoras y a firmar exclusivas que solo suenan dentro de su aplicación; y una parte creciente de lo que hoy se llama podcast es vídeo en YouTube sin ningún feed detrás. Un programa que solo existe dentro de una aplicación se apaga el día que esa empresa lo decida, igual que se apagaron Fotolog o La Coctelera, y sin que el autor pueda llevárselo.
Qué se puede recuperar
De los primeros años en español queda menos de lo que parece. Los MP3 pesaban, los alojamientos gratuitos se limpiaron solos y el archivo de la web guarda las páginas pero rara vez los ficheros de audio enlazados desde ellas. Para reconstruir aquel mapa, el sitio por donde empezar es el histórico de podcastellano.com en la Wayback Machine, donde están las listas de programas de 2005 con sus direcciones originales; muchos feeds están muertos, pero el nombre y la fecha permiten buscar el rastro en otro sitio.
La especificación que lo hizo posible sigue publicada y sin cambios sustanciales: la etiqueta enclosure ocupa cuatro líneas en el documento de RSS 2.0. El artículo donde se bautizó todo esto también sigue en su sitio, en The Guardian del 12 de febrero de 2004. Y cualquiera puede comprobar el mecanismo entero en treinta segundos: buscar el enlace de RSS de un podcast que escuche, abrirlo en el navegador y mirar el XML en crudo. Ahí está la dirección del fichero, en texto plano, igual que la puso Gelado en octubre de 2004.